Lo que escribí sobre productos de IA generativa en febrero de 2025, y lo que cambió
Releí un marco que escribí para diseñar productos de IA generativa. Qué resistió, qué envejeció y qué apareció con los agentes.
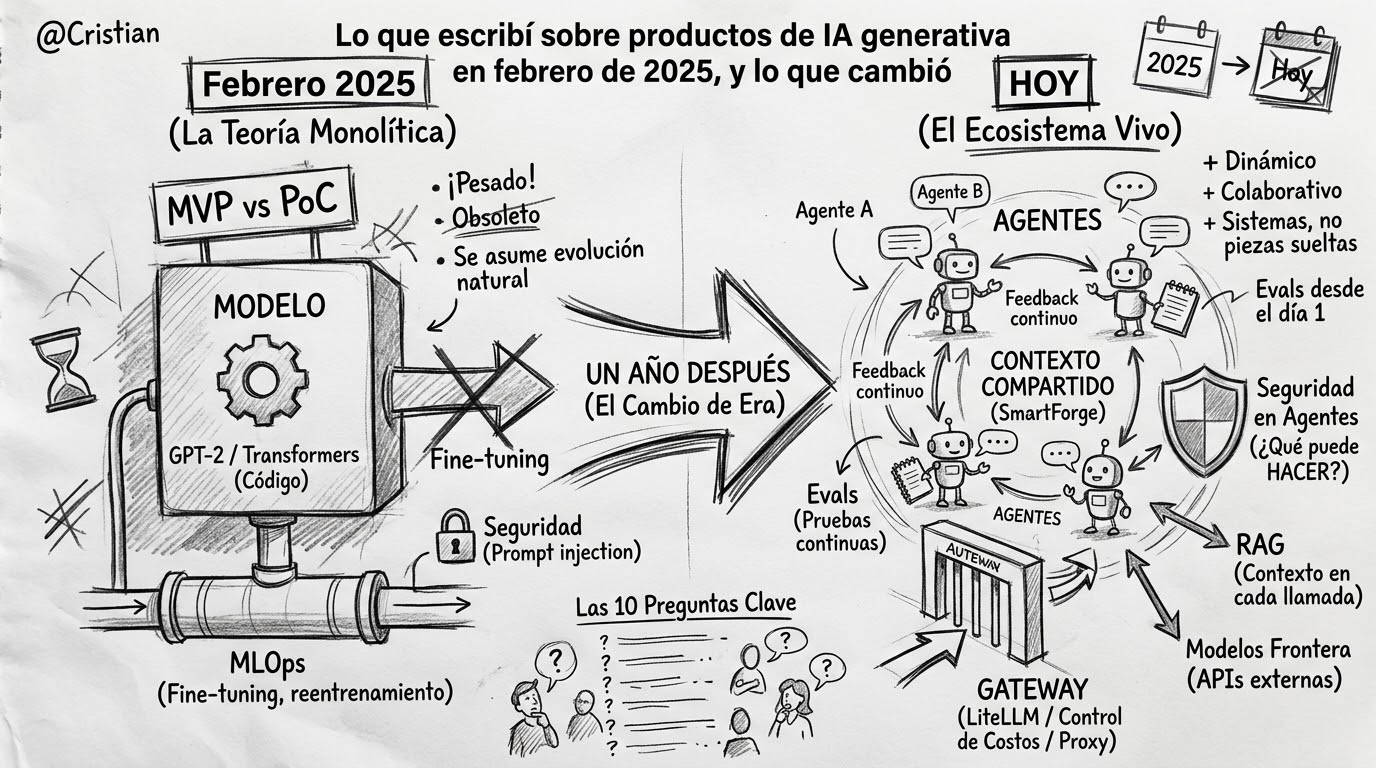
En febrero de 2025 escribí un documento interno en SmartJob llamado “Diseño de Productos de IA Generativa”. La idea era tener un marco común para los proyectos de IA generativa (chatbots, generadores de contenido, automatización de procesos), de modo que cada uno partiera con las mismas preguntas y no desde cero.
El documento tenía tres partes. La primera era un proceso en cinco etapas: alcance y objetivos de negocio, comprensión de los datos, selección de tecnología y desarrollo del modelo, pruebas piloto, y despliegue con monitoreo continuo. Cada etapa cerraba con una lista de preguntas clave.
La segunda parte era una arquitectura de referencia en cuatro capas (procesamiento de datos, modelo generativo, retroalimentación y despliegue), junto con una comparación entre SaaS, PaaS y on-premise. La tercera cubría seguridad, privacidad y cumplimiento: GDPR, ISO 27001, prompt injection y planes de respuesta ante incidentes.
Lo releí esta semana. Algunas partes resistieron bien y otras parecen escritas en otra época. En esta industria, un año es efectivamente otra época. Este post separa una cosa de la otra.
Lo que sigue vigente
Decidir si partes del negocio o de la tecnología
La distinción más útil del documento era entre MVP y PoC. Un MVP parte de un problema de negocio concreto y diseña la solución para resolverlo. Una PoC parte de la tecnología, explora lo que puede hacer y después busca dónde aplicarla.
Ambas son válidas, pero conviene decidirlo al comienzo y de forma explícita. Muchas iniciativas fracasan por mezclarlas: se presentan como MVP, se ejecutan como exploración y al final nadie sabe contra qué métrica evaluarlas. Una PoC necesita una pregunta clara y un plazo. Un MVP necesita un KPI de negocio y un dueño del proceso.
La calidad del contexto define el techo
“Basura que entra, basura que sale” sigue siendo cierto. Cambió el lugar donde se aplica. En 2025 pensaba en datos de entrenamiento y fine-tuning. Hoy pienso en el contexto que recibe el modelo en cada llamada: los documentos que recupera un RAG, las descripciones de las herramientas, el historial de la conversación.
Un modelo excelente con documentación desactualizada responde con total seguridad cosas incorrectas.
Seguridad desde el diseño
El documento mencionaba prompt injection como un riesgo entre varios. Hoy lo pondría primero. Cuando el modelo solo respondía texto, una inyección producía una respuesta inapropiada. Cuando el modelo lee correos, consulta sistemas y ejecuta acciones, una inyección puede filtrar datos o modificar algo real.
Lo que envejeció
El ejemplo de código
El documento incluía un ejemplo que cargaba GPT-2 con la biblioteca Transformers. Era didáctico, pero hoy nadie parte un producto así. Se parte con la API de un modelo frontera, se valida el caso de uso y recién después se evalúa si hace falta algo propio.
Fine-tuning como camino natural
El marco asumía que el producto evolucionaba ajustando y reentrenando el modelo. En la práctica, la mayoría de las mejoras vienen de otros lados: mejor prompting, mejor recuperación de información, mejores herramientas y modelos base más nuevos. El fine-tuning queda para casos específicos y suele ser la última palanca.
El vocabulario MLOps
Feature stores, model drift, reentrenamiento trimestral. Vengo de DataOps y MLOps, y el documento heredó ese marco mental. Funciona bien para modelos predictivos.
En productos generativos que consumen modelos de terceros, los problemas operativos son otros: versiones de modelo que el proveedor cambia o retira, costo por token, latencia y salidas que no tienen una única respuesta correcta.
Lo que no estaba en el documento
Agentes
El documento pensaba en sistemas monolíticos: un modelo, una entrada, una salida. Chatbots, generadores de contenido, optimizadores de procesos. Quedó obsoleto del todo cuando empezamos a construir agentes que interactuaban entre sí.
SmartForge, la plataforma multiagente de entrega de software que construimos con el equipo en SmartJob, partió como un sistema monolítico. Después lo dividimos en agentes independientes, cada uno con su tarea. Con el tiempo esos agentes se volvieron codependientes: la salida de uno es la entrada de otro.
Ahí apareció el hallazgo más importante. Al principio cada agente tenía un prompt que describía solo su tarea. Hacía bien su parte, pero no sabía para qué servía ni quién iba a leer lo que producía. Cada uno se preocupaba únicamente de su propia respuesta.
El cambio fue darles a todos el mismo contexto de sistema: qué es el sistema completo, cuál es su objetivo, cuáles son los pasos y qué papel cumple cada agente. Sobre eso, cada agente mantiene su propio prompt con lo que le toca hacer. Con ese contexto compartido, cada agente entiende que su salida tiene que servirle al siguiente, porque otro agente la va a leer.
La diferencia en precisión y en la calidad de lo que entrega el sistema fue enorme. Los mismos agentes rinden mucho más trabajando como sistema que como piezas aisladas. Diseñar un producto con agentes se parece a armar un equipo de trabajo: cada integrante necesita conocer su tarea y también el proyecto del que forma parte.
Un gateway entre las aplicaciones y los modelos
Cuando varios equipos y productos consumen LLMs, aparece una necesidad que el documento no anticipaba: una capa central de acceso. En nuestro caso es un proxy con LiteLLM que concentra las credenciales, asigna presupuestos por equipo, enruta entre proveedores y registra el uso.
Sin esa capa, el control de costos y la auditoría quedan dispersos en cada aplicación.
Evals
La sección de pruebas era la más débil del documento. Hablaba de pruebas unitarias y retroalimentación de usuarios, sin un método para medir calidad cuando la salida es texto libre.
Hoy considero las evals parte del producto desde el primer día: un conjunto de casos representativos, criterios explícitos de lo que es una buena respuesta y una forma de correrlos cada vez que cambia el prompt, el modelo o los datos. Sin evals, cambiar de modelo es una apuesta.
Seguridad en agentes
Con agentes, la pregunta de seguridad pasa de “qué puede decir el modelo” a “qué puede hacer”. Importa qué herramientas tiene disponibles, con qué permisos, qué acciones requieren aprobación humana y qué datos puede leer o enviar a terceros. Todo lo que el agente lee desde fuentes externas debe tratarse como dato y jamás como instrucción.
Las preguntas que haría hoy antes de empezar
- ¿Esto es un MVP con un KPI de negocio o una PoC con una pregunta y un plazo?
- ¿Quién es el dueño del proceso que se va a modificar?
- ¿Qué información necesita el modelo en cada llamada y quién la mantiene actualizada?
- ¿El producto solo responde o también ejecuta acciones?
- ¿Qué acciones requieren aprobación humana?
- ¿Cómo vamos a medir si una respuesta es buena, con casos concretos?
- ¿Qué pasa cuando el proveedor cambia o retira el modelo?
- ¿Cuánto cuesta cada interacción y quién controla el presupuesto?
- ¿Qué datos salen de la organización y hacia dónde van?
- ¿Qué registro queda para auditar lo que hizo el sistema?
Cierre
El marco del año pasado sirvió. La estructura por etapas, la distinción entre MVP y PoC y la preocupación por los datos y la seguridad siguen en pie. Cambiaron las prioridades: menos foco en el modelo y más en el contexto, las herramientas, la medición y el control.
Probablemente dentro de un año algo de este post también habrá envejecido. Por eso vale la pena escribirlo.
Este post refleja mi experiencia y opinión personal y no representa a SmartJob ni a sus clientes.